
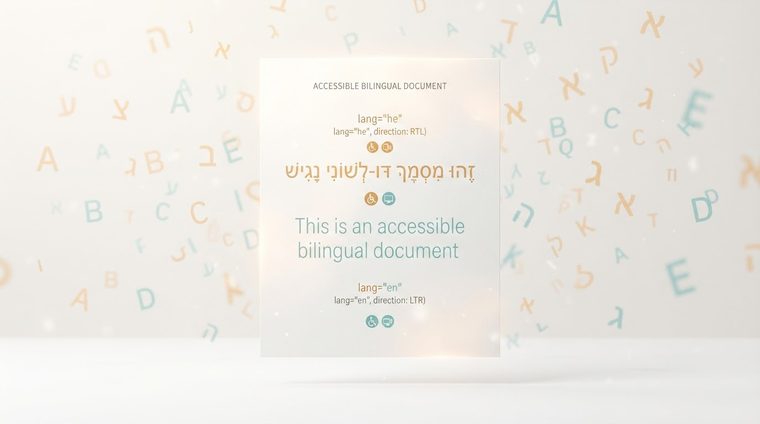
スクリーンリーダーがヘブライ語の文章を声に出して読み上げようとしているが、そのテキストは英語で書かれていると「思っている」と想像してみてください。その結果、テキスト自体は完全に正しく書かれているにもかかわらず、文字が逆に聞こえたり、単語が間違って接続されたり、文章全体が理解不能になったりします。理由: ドキュメントの言語タグが欠落しているか間違っています。これは、バイリンガルまたは多言語ドキュメントで最も一般的な問題の 1 つであり、修正が最も簡単な問題の 1 つでもあります。
要するに、このガイドの内容
言語タグ付けが読書方向に影響を与える理由
アクセス可能なすべてのデジタル ドキュメント (HTML または PDF) には、定義された言語タグが必要です (たとえば、heヘブライ語の場合、en英語)。このタグは、スクリーン リーダーが正しいアクセントと発音を選択するのに役立つだけでなく、読み取り方向(RTL 対 LTR)。タグが欠落していると、読み取りソフトウェアが誤った推測を行う可能性があり、場合によっては、画面上の表示が完全に正常に見えても、文字や単語が逆の順序で読み上げられることがあります。
Word で言語を設定する方法
Word では、文書のデフォルト言語は、「校閲」▸「言語」▸「校正言語の設定」で設定されます。そこで「ヘブライ語」を選択し、文書のデフォルトとしてマークします。重要: ソフトウェア自体の表示言語のみを変更しても、ドキュメントに埋め込まれている言語タグは変更されません。この設定がドキュメントのコンテンツに適用されていること、および PDF にエクスポートするときにその設定が保持されていることを確認する必要があります。
Acrobat で言語を設定する方法
文書が Word から正しくエクスポートされた場合でも、Acrobat で確認する価値があります: 文書のプロパティ ▸ 詳細 ▸ 読み取りオプション — ここで文書全体のデフォルト言語が設定されます。文書全体の言語とは異なる言語で書かれた特定のテキストの一節 (ヘブライ語文書内の英語の引用など) については、タグ ツリーでその一節を選択し、タグのプロパティを開いて、[タグ] タブでそのセグメントの特定の言語を選択できます。
ヘブライ語と英語が混在する文書
多くのビジネス文書には、ヘブライ語と英語の用語、製品名、または電子メール アドレスが混在しています。ほとんどの場合、ドキュメント全体の言語が正しく設定されている限り、Unicode Bidi アルゴリズム (双方向テキストを処理する) はヘブライ語文内のこのような短いセグメントを正しく処理します。この問題は主に、文書内の段落全体が別の言語で書かれている場合にさらに悪化します。段落自体と段落を囲む内容の両方を正しく読むために、上記のように個別にタグ付けする価値があります。
💡 実践的なヒント
クイックチェック: Acrobat でドキュメントのプロパティを開き、言語フィールドを確認します。空または「不明」の場合は、他のアクセシビリティ チェックの前に、最初に修正する必要があります。
ドキュメントの言語が正しく設定されているかどうかわからない場合は、
当社のツールは、完全自動スキャンの一環として、サイト上のすべての PDF ファイルの言語タグ付けをチェックします。
あなたのサイトを無料でスキャンしてください ←