
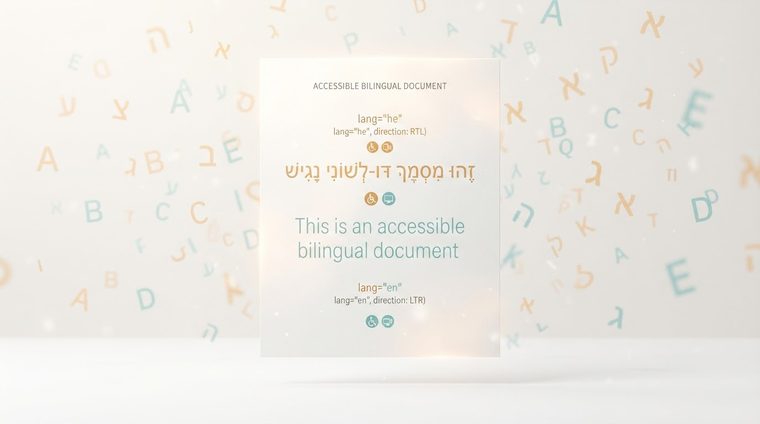
Próbáljon elképzelni egy képernyőolvasót, aki megpróbál hangosan felolvasni egy héber mondatot, de "gondolkodik" a szöveg angolul van írva. Az eredmény: fordítottan hangzó betűk, hibásan összekapcsolódó szavak és egy egész mondat, amely érthetetlenné válik – annak ellenére, hogy maga a szöveg tökéletesen helyesen van megírva. Az ok: a dokumentum nyelvi címkéje hiányzik vagy hibás. Ez az egyik leggyakoribb probléma a két- vagy többnyelvű dokumentumokban, és egyben az egyik legkönnyebben megoldható probléma.
Röviden: miről szól ez az útmutató
Miért befolyásolja a nyelvi címkézés az olvasás irányát?
Minden hozzáférhető digitális dokumentumhoz – HTML vagy PDF – meghatározott nyelvi címkét kell megadni (példáulhehéberül,enangolra). Ez a címke nem csak abban segít a képernyőolvasóban, hogy megválassza a helyes ékezetet és kiejtést, hanem meghatározza aolvasási irány(RTL vs. LTR) a szövegből. Ha a címke hiányzik, az olvasószoftver hibásan tippelhet, és bizonyos esetekben ez a betűk vagy szavak fordított sorrendben történő kiolvasását eredményezi, még akkor is, ha a képernyőn látható vizuális megjelenítés teljesen rendben van.
A Word nyelvének beállítása
A Wordben a dokumentum alapértelmezett nyelve az Áttekintés ▸ Nyelv ▸ Lektorálási nyelv beállítása alatt van beállítva – itt kiválasztja a "héber" lehetőséget, és megjelöli a dokumentum alapértelmezett nyelveként. Fontos: magának a szoftvernek a megjelenítési nyelvének megváltoztatása nem változtatja meg a dokumentumba ágyazott nyelvi címkét. Győződjön meg arról, hogy ezt a beállítást alkalmazza a dokumentum tartalmára, és megőrzi azt a PDF-be exportáláskor.
A nyelv beállítása az Acrobatban
Még ha a dokumentumot megfelelően exportálták is a Wordből, érdemes megerősíteni az Acrobat: Dokumentum tulajdonságai ▸ Speciális ▸ Olvasási beállítások menüpontban – itt van beállítva a teljes dokumentum alapértelmezett nyelve. A dokumentum általános nyelvétől eltérő nyelvű meghatározott szövegrészek esetén (például egy héber dokumentumban található angol idézet) kiválaszthatja azt a részt a Címkék fában, megnyithatja a címke tulajdonságait, és kiválaszthatja az adott szegmens nyelvét a Címke lapon.
A héber és az angol nyelvet keverő dokumentumok
Sok üzleti dokumentum keveri a héber nyelvet angol kifejezésekkel, terméknevekkel vagy e-mail címekkel. A legtöbb esetben a Unicode Bidi algoritmus (amely a kétirányú szöveget kezeli) megfelelően kezeli az ilyen rövid szegmenseket egy héber mondaton belül, mindaddig, amíg a dokumentum általános nyelve helyesen van beállítva. A probléma főleg akkor súlyosbodik, ha egy dokumentumon belül különböző nyelvű teljes bekezdések vannak – ezeket érdemes a fent leírtak szerint külön felcímkézni, hogy mind a bekezdés, mind pedig a körülötte lévő szöveg helyes olvasható legyen.
💡 Gyakorlati tipp
Gyors ellenőrzés: nyissa meg a dokumentum tulajdonságait az Acrobatban, és ellenőrizze a nyelvi mezőt. Ha üres vagy „Ismeretlen” – ez az első dolog, amit ki kell javítani, mielőtt bármilyen más akadálymentesítési ellenőrzést végeznénk.
Nem biztos benne, hogy a dokumentumok nyelve megfelelően van beállítva?
Eszközünk a teljes automatikus vizsgálat részeként ellenőrzi a nyelvi címkézést a webhelyén található minden PDF-fájlban.
Ingyen átvizsgálja webhelyét ←